
A granularidade de dados é um dos pilares mais importantes da modelagem de um projeto analítico. Caso ela não esteja de acordo com as necessidades do modelo, isso pode até mesmo inviabilizar o projeto – uma vez que o nível de detalhamento impacta diretamente no desempenho, volume de armazenamento e usabilidade dos dados.
Neste artigo, você vai entender:
- O que é granularidade de dados e como o nível de detalhamento impacta análises, armazenamento e performance dos sistemas.
- A diferença entre alta e baixa granularidade, com exemplos práticos aplicados a Business Intelligence e Analytics.
- Por que a granularidade é importante em projetos analíticos, influenciando consultas, dashboards e tomada de decisão.
- Como definir a granularidade ideal dos dados considerando objetivos de negócio, fontes de dados e modelos analíticos.
- Quais ferramentas, modelos e estratégias ajudam a equilibrar detalhamento, escalabilidade e eficiência operacional.
Leia o artigo e entenda melhor o que é granularidade de dados, por que ela é tão importante e veja como adotar estratégias que combinem detalhamento e eficiência.
O que é granularidade de dados?
Granularidade de dados é um termo que se refere ao nível de detalhamento das informações em um data warehouse. Em outras palavras, trata-se do grau de detalhe ou precisão com que os dados são registrados e analisados.
Para entender melhor como funciona, imagine que você está analisando os dados dos clientes de um banco e pode visualizar essas informações de duas formas diferentes:
- Usuário 1 – Nome completo, data de nascimento, número da conta.
- Usuário 1 – Primeiro nome, sobrenome, data de nascimento, número da conta, endereço.
No exemplo 1, a granularidade é menor; no exemplo 2, ela é maior. Assim como aprendemos em química, em que uma partícula é formada por átomos, na granularidade de dados funciona de forma semelhante: o usuário é composto por partes menores que carregam informações, sendo essas partes compartimentalizadas em pedaços cada vez menores — o que confere maior riqueza de detalhes ao objeto de análise.
Alta granularidade x baixa granularidade: entenda a diferença
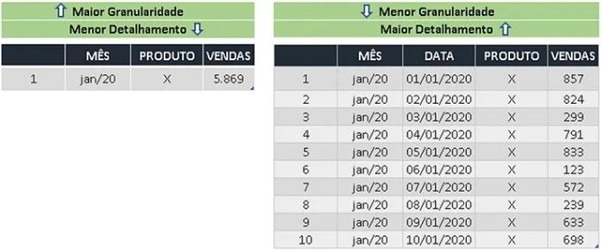
Quando falamos em alta granularidade, estamos nos referindo a um maior nível de detalhamento. Para simplificar, pense que, se você dividir um pão em dois pedaços, ele terá uma baixa granularidade (pedaços maiores). Se dividir em quatro pedaços, terá uma alta granularidade (pedaços menores).
Dessa forma, estabelecemos que granularidade e detalhamento assumem uma relação inversamente proporcional. Portanto:
- Alta granularidade → dados mais detalhados
- Baixa granularidade → dados mais resumidos ou agregados
| Tipo de dado | Nível de granularidade |
|---|---|
| Vendas por minuto e por cliente | Alta granularidade |
| Total de vendas por mês | Baixa granularidade |
Quanto maior a granularidade, maior o volume de dados armazenados e maior a capacidade de análises profundas.
Por que investir em granularidade de dados?
É importante saber que granularidade e agregação de dados podem gerar um volume imenso de informações à medida que transações são realizadas em um sistema. Isso pode interferir no funcionamento das aplicações e, principalmente, no tempo de resposta durante consultas realizadas pelos usuários.
Portanto, a granularidade de dados é uma estratégia que ajuda a definir quais informações devem permanecer no data base e quais devem ser armazenadas no data warehouse, evitando sobrecargas no sistema e otimizando recursos financeiros.
Vantagens da gestão da granularidade de dados
- Tomada de decisão
- Quanto mais detalhados os dados, maior será a capacidade de realizar análises profundas para identificar padrões ou anomalias.
- Segmentações mais precisas são fundamentais para decisões estratégicas mais direcionadas e baseadas em evidências reais.
- Estrutura e funcionamento do projeto
- A granularidade influencia a modelagem do banco de dados, o desenho de tabelas e os relacionamentos entre entidades.
- Um bom equilíbrio entre detalhamento e desempenho ajuda a manter a integridade dos dados sem sobrecarregar o sistema.
- Agilidade nas consultas
- Uma granularidade adequada melhora a performance de consultas e dashboards, evitando lentidões desnecessárias.
- É possível criar visões agregadas (por exemplo: dados por semana ou por região) para consultas rápidas, ao mesmo tempo em que o dado bruto permanece disponível para análises profundas.
Ponto de atenção: a definição da granularidade deve estar alinhada aos objetivos do projeto e às perguntas de negócio que se deseja responder.
Granularidade de dados e Inteligência Artificial
A granularidade de dados tem impacto direto no desempenho de projetos de Inteligência Artificial, Machine Learning e Analytics. Dados muito agregados podem limitar a identificação de padrões e comportamentos importantes, enquanto dados excessivamente detalhados aumentam custos de processamento, armazenamento e infraestrutura.
Por isso, encontrar o nível ideal de detalhamento é essencial para garantir eficiência operacional e análises mais precisas. Uma arquitetura de dados bem estruturada reduz gastos com cloud computing, acelera consultas em dashboards e otimiza pipelines de dados e modelos de IA.
Segundo a IBM, problemas relacionados à qualidade e estrutura dos dados podem gerar perdas milionárias e comprometer a performance de sistemas analíticos e aplicações de Inteligência Artificial.
Além de melhorar a escalabilidade dos projetos, uma estratégia eficiente de granularidade facilita a implementação de IA generativa e analytics avançado. Dessa forma, a granularidade se tornou um fator estratégico em projetos modernos de Big Data e Business Intelligence.
Como escolher o nível de granularidade dos meus dados?
Mesmo que, num primeiro momento, ter muitas informações ao alcance pareça uma boa estratégia, é preciso saber quais delas são realmente relevantes para as análises. Para isso, é necessário considerar alguns fatores:
1. Defina seus objetivos
Qual será a missão do modelo analítico? O que se pretende alcançar e quais serão as fontes de dados utilizadas?
Definir objetivos ajuda a identificar necessidades específicas e facilita a escolha das fontes de dados, métricas, dimensões e filtros relevantes que devem compor o modelo.
2. Avalie suas fontes de dados
O segundo passo é verificar suas fontes de dados — suas características, variedade, velocidade e autenticidade. É essencial compreender toda a gestão do big data, como os dados são coletados, armazenados e processados na nuvem.
Também é importante considerar limitações e custos, como capacidade de armazenamento, largura de banda, latência e segurança. Esses fatores estão diretamente relacionados ao nível de granularidade possível.
3. Escolha seu modelo de dados
O modelo de dados define a estrutura para análise e visualização. Veja algumas opções:
- Relacional: Organiza os dados em tabelas (linhas e colunas). Criado por E. F. Codd na IBM nos anos 70, esse modelo permite relacionar tabelas usando um atributo comum.
- Dimensional (Kimball): Otimiza dados para recuperação eficiente em data warehouses. Utilizado amplamente em CRMs, é ideal para representar objetos de análise de forma simples.
- NoSQL: Utiliza formatos flexíveis como documentos JSON. Não exige esquema fixo, o que facilita a escalabilidade e o gerenciamento de dados distribuídos em múltiplos servidores.
4. Projete sua visualização de dados
Independentemente do modelo escolhido, a visualização adequada é crucial para o sucesso das análises. Algumas ferramentas úteis:
- Power BI: permite criar painéis interativos com integração de diferentes fontes.
- Tableau: possibilita análise e gestão de dados com criação de relatórios, planilhas e dashboards.
- Qlik: oferece um pipeline completo e em tempo real, sem necessidade de programação.
Veja também: QlikTableau ou Power BI: quais são as melhores ferramentas de Bi para sua empresa?
Refinamento contínuo
Com as ferramentas e estratégias certas em mãos, é hora de refinar suas análises e o nível de granularidade. Monitore os resultados, realize testes e revise periodicamente suas fontes de dados. Ao identificar novas tendências ou padrões, adapte-se — é essencial manter-se atento.
Como vimos, entender a granularidade de dados é fundamental para o sucesso de um projeto analítico e para a economia de tempo e recursos. Por isso, é importante contar com o suporte de profissionais especializados.
A granularidade de dados impacta diretamente a performance, escalabilidade, os custos operacionais e a qualidade das análises.
Por isso, antes de modelar um data warehouse ou projeto analítico, é fundamental entender quais perguntas de negócio precisam ser respondidas e qual profundidade de dados será necessária para gerar insights relevantes.
FAQ sobre granularidade de dados
O que significa granularidade de dados?
Granularidade de dados é o nível de detalhamento das informações armazenadas em um sistema analítico, banco de dados ou data warehouse.
Qual a diferença entre alta e baixa granularidade?
Alta granularidade representa dados detalhados e específicos, enquanto baixa granularidade representa dados resumidos ou agregados.
Como a granularidade impacta a performance?
Quanto maior o detalhamento dos dados, maior tende a ser o volume processado em consultas, dashboards e relatórios, podendo impactar desempenho e custos computacionais.
Qual a granularidade ideal para um data warehouse?
A granularidade ideal depende dos objetivos do negócio, do volume de dados e das análises que precisam ser realizadas.
Descubra qual é a granularidade ideal para o seu projeto e tenha acesso ao suporte dos melhores profissionais. Converse com a Kriptos.


